Handbuch · Kapitel 19 · Teil D Betrieb im Alltag
Verbrauch und Kosten
Wozu
Jeder Aufruf eines Sprachmodells kostet Geld, meist Bruchteile eines Cents, in Summe aber spürbar. dAI Pro protokolliert jeden Aufruf je Sammlung, Zweck und Modell und rechnet ihn mit hinterlegten Listenpreisen in Kosten um. So sehen Sie, was der Chat, die Suche, die Agenten und die Indexierung kosten, und was eine gelöste Anfrage im Durchschnitt wert ist.
Wo
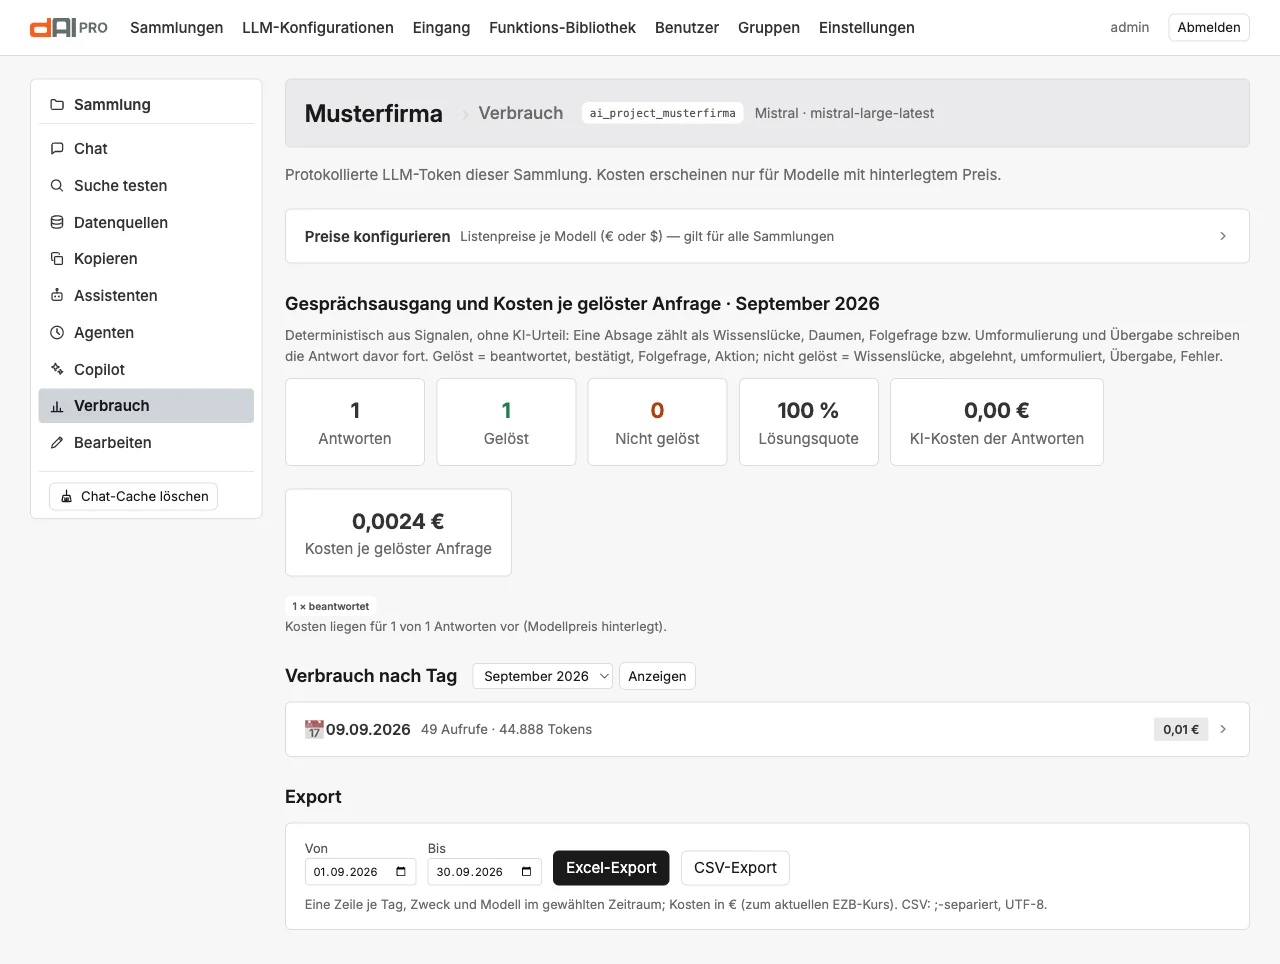
Öffnen Sie in der Sammlungs-Schiene Verbrauch.
Preise hinterlegen
Der Kasten Preise konfigurieren gilt für alle Sammlungen der Instanz. Je Modell tragen Sie die Listenpreise des Anbieters ein: Eingabe und Ausgabe je Million Tokens, für Texterkennung je 1.000 Seiten, für Audio je Minute, für Bildmodelle je Bild (Spalte „€/Bild“), dazu den Anteil, den ein Treffer im Zwischenspeicher des Anbieters kostet. Preise in der Währung des Anbieters; Dollar-Preise rechnet dAI Pro zum aktuellen Referenzkurs der Europäischen Zentralbank in Euro um. Ohne Preis erscheinen nur Tokens, keine Kosten.
Für Bildmodelle gilt eine eigene Regel. Meldet das Bildmodell Tokens und sind für das Modell Token-Preise hinterlegt, rechnet dAI Pro genau nach Tokens. Der Preis je Bild gilt nur für Bildmodelle, die keine Tokens melden, oder wenn keine Token-Preise hinterlegt sind. dAI Pro rechnet nie beides für dasselbe Bild. OpenAI und Gemini melden für jedes Bild Tokens. Für ihre aktuellen Bildmodelle tragen Sie deshalb die Token-Preise ein; für das abgekündigte gemini-2.5-flash-image genügt der Preis je Bild, solange für das Modell keine Token-Preise hinterlegt sind.
Nach Tokens zu rechnen lohnt sich, weil der Preis eines Bildes stark schwankt. Bei OpenAI hängt er vor allem an der Qualität: Ein Bild in „Hoch“ kostet rund das Sechsfache von „Standard“. Referenzbilder aus dem Corporate Design kosten zusätzlich Eingabe-Tokens. Die Preistabelle kennt je Modell einen Eingabepreis; dAI Pro rechnet alle Eingabe-Tokens dazu, auch die der Referenzbilder. Bei den OpenAI-Bildmodellen ist deshalb der Preis für Bild-Eingabe eingetragen, weil Referenzbilder den größten Teil der Eingabe ausmachen. Aufträge ohne Referenzbilder werden damit um Bruchteile eines Cents zu hoch geschätzt.
| Bildmodell | Listenpreis des Anbieters (Stand September 2026) | Was ein Bild ungefähr kostet |
|---|---|---|
gpt-image-2.5-flare, gpt-image-2.5-sunburst (OpenAI) | Text-Eingabe 5 $, Bild-Eingabe 8 $, Bild-Ausgabe 30 $ je Million Tokens | Ausgabe bei 1024 × 1024 oder 1536 × 864 Pixeln: „Entwurf“ rund 200 Tokens (etwa 0,006 $), „Standard“ rund 280 Tokens (etwa 0,008 $), „Hoch“ rund 1.750 Tokens (etwa 0,05 $), jeweils zuzüglich Eingabe |
gemini-3.1-flash-image (Google) | Bild-Ausgabe 60 $ je Million Tokens | rund 1.120 Bild-Tokens je Bild in der Stufe 1K, also etwa 0,067 $ |
gemini-2.5-flash-image (Google, abgekündigt) | 0,039 $ je Bild | 0,039 $ |
Die Werte gelten für die kleinste Größe. Größere Formate und höhere Auflösungen (Kapitel 18) kosten mehr Ausgabe-Tokens: bei OpenAI mit der Pixelzahl, bei Gemini mit der Stufe 2K oder 4K. Bilder, die Sie für einen Auftrag hochladen, zählen wie Referenzbilder als Bild-Eingabe. Schaubilder kosten in jeder Größe nur den Aufruf des Chat-Modells.
Bei den gpt-image-2.5-Modellen liegen „Sehr hoch“ und „Maximal“ noch einmal deutlich über „Hoch“; die tatsächlichen Tokens jedes Auftrags stehen nach dem Lauf im Verbrauch. Jede Variante und jede Bearbeitung mit Hinweis zählt als eigenes Bild. Text als eigene Ebene kostet keine Bild-Tokens, nur einen Aufruf des Render-Dienstes.
Gesprächsausgang und Kosten je gelöster Anfrage
Der obere Block bewertet den laufenden Monat ohne KI-Urteil, allein aus Signalen: Eine Absage zählt als Wissenslücke; Daumen, Folgefrage, Umformulierung und Übergabe schreiben die Antwort davor fort.
| Kennzahl | Bedeutung |
|---|---|
| Antworten | Alle Antworten des Chats im Monat. |
| Gelöst | Beantwortet, bestätigt, Folgefrage, Aktion ausgelöst. |
| Nicht gelöst | Wissenslücke, abgelehnt, umformuliert, Übergabe, Fehler. |
| Lösungsquote | Gelöst geteilt durch alle. |
| KI-Kosten der Antworten | Kosten aller Antworten mit hinterlegtem Preis. |
| Kosten je gelöster Anfrage | Die Zahl, die zählt: Was kostet eine Anfrage, die der Chat wirklich erledigt hat. |
Verbrauch nach Tag
Je Tag ein aufklappbarer Block mit Aufrufen, Tokens und Kosten, darin die Tabelle je Zweck und Modell:
| Spalte | Bedeutung |
|---|---|
| Für was | Der Zweck: Chat, Suche, Embedding, Agent, Copilot, Copilot-Bilder, Sprach-Chat, Endpunkt für Agenten. |
| Modell | Das verwendete Modell. |
| Aufrufe | Anzahl der Aufrufe. |
| Tokens ein, davon Cache-Treffer, davon Cache neu | Eingabe-Tokens und wie viele davon aus dem Zwischenspeicher des Anbieters kamen. Ein hoher Anteil Cache-Treffer macht den CAG-Modus günstig. |
| Tokens aus | Ausgabe-Tokens. |
| Seiten, Minuten | Für Texterkennung und Audio. |
| Kosten | Nach hinterlegtem Preis, in Euro. |
Der Redaktions-Copilot (Kapitel 18) verteilt sich auf zwei Zwecke. Unter „Copilot“ stehen die Texte, die Bildaufträge, die Struktur der Schaubilder, die Texte der Dokumente samt ihren Schaubildern und die Prüfaufrufe der Selbstkontrolle. Unter „Copilot-Bilder“ stehen die erzeugten Illustrationen, auch ein zweites Bild nach einer Abweichung.
Export
Excel-Export und CSV-Export liefern eine Zeile je Tag, Zweck und Modell im gewählten Zeitraum, mit Kosten in Euro. Für die Kostenstelle, für den Abgleich mit der Rechnung des Anbieters oder für eigene Auswertungen.
Was Kosten treibt
- Lange Antworten und lange Gespräche. Jede Antwort trägt den Verlauf mit. Der Haupt-Prompt darf knapp sein.
- Suche beim Tippen (Kapitel 9): jede Zwischeneingabe eine Zusammenfassung.
- Neu indexieren. Jedes verarbeitete Dokument kostet Embeddings; der Frische-Wächter verarbeitet nur Geändertes.
- Agenten mit KI-Urteil: Qualitätsprüfung, Golden Set mit Richter, Inhalts-Wächter. Ihr Zeitplan bestimmt die Kosten.
- Illustrationen: jedes Bild, dazu die Selbstkontrolle und gegebenenfalls ein zweites Bild. Die Qualität „Hoch“ kostet ein Vielfaches von „Standard“. Günstiger wird es mit der Qualität „Entwurf“ oder ohne Selbstkontrolle. Schaubilder kosten nur einen Aufruf des Chat-Modells.
- Dokumente: ein Aufruf des Chat-Modells mit viel Kontext, dazu einer je Schaubild. Ein fertiger Textentwurf, der mit Als PDF und Word gesetzt wird, kostet keinen Aufruf.
- Der Antwort-Cache spart: Gleiche Fragen kosten kein zweites Mal.
Häufige Fragen
Die Kosten stehen auf 0,00 Euro. Für das Modell ist kein Preis hinterlegt. Tragen Sie ihn im Kasten „Preise konfigurieren“ ein; die Umrechnung gilt rückwirkend für den Verbrauch.
Die Summe weicht von der Rechnung des Anbieters ab. Listenpreise, Kursschwankungen und Rundungen. Der Verbrauch in Tokens stimmt; die Kosten sind eine Schätzung auf Listenpreisbasis.
Zählt der Test-Chat im Backend mit? Ja, wie jeder andere Aufruf.
Ich habe einen Preis je Bild eingetragen, aber die Kosten folgen den Tokens. Für das Modell sind auch Token-Preise hinterlegt, und das Modell meldet Tokens. Dann rechnet dAI Pro nach Tokens. Wollen Sie je Bild rechnen, leeren Sie die Token-Preise des Modells.
Siehe auch
- Kapitel 15 · Agenten
- Kapitel 16 · Qualitäts-Cockpit
- Kapitel 18 · Redaktions-Copilot (Illustrationen, Schaubilder, Dokumente)
- Kapitel 24 · Sprachmodelle konfigurieren